- 首頁
- 知識庫
- SEO 搜尋引擎最佳化
- robots.txt 怎麼寫?語法、常見錯誤與測試方法
SEO 搜尋引擎最佳化
robots.txt 怎麼寫?語法、常見錯誤與測試方法
作者:JamXu更新日期:2026-10-11
robots.txt 是放在網站根目錄的純文字檔,用 User-agent、Disallow、Allow 與 Sitemap 幾個欄位,告訴搜尋引擎檢索器哪些網址可以抓、哪些不要抓。它控制的是「檢索」而不是「收錄」:被 Disallow 的網址仍可能因外部連結出現在搜尋結果中,想讓網頁不出現請改用 noindex 或密碼保護。寫好後用 Search Console 的 robots.txt 報表與網址檢查工具確認生效。
robots.txt 是什麼?它管的是「檢索」,不是「收錄」
一句話定義:robots.txt 是一個放在網站根目錄、名稱固定為 robots.txt 的純文字檔,用來告訴搜尋引擎的檢索器(爬蟲)可以存取網站上的哪些網址。任何人都能在瀏覽器網址列輸入「網域/robots.txt」看到它,例如 example.com/robots.txt。
根據 Google 搜尋中心的〈robots.txt 簡介〉,這個檔案的主要用途是管理檢索器對網站造成的流量,避免網站因為要求過多而超載,或讓 Google 少花時間在不重要、內容相似的網頁上;它並不是讓網頁從 Google 搜尋結果消失的工具。這一點是整篇文章最重要的觀念,後面幾乎每一個常見錯誤,都跟搞混「檢索」和「收錄」有關。
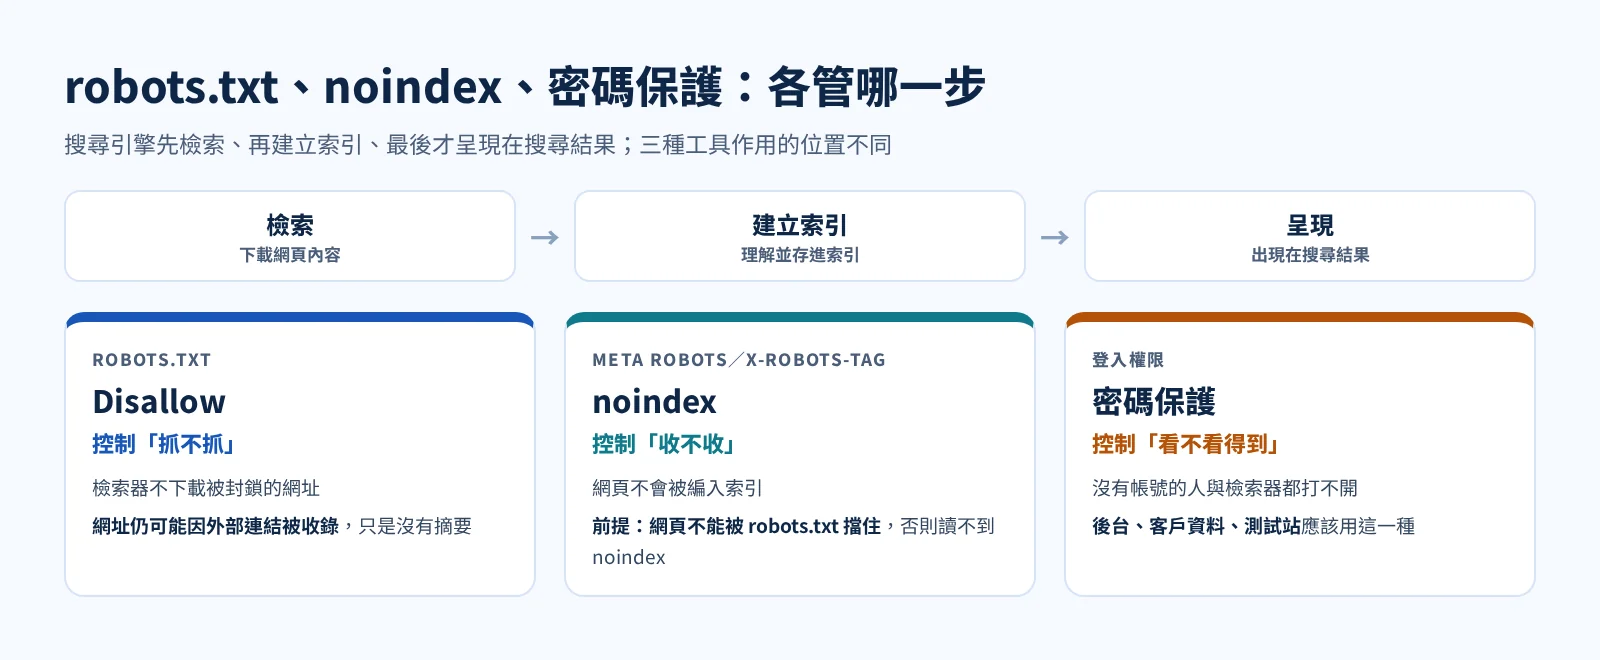
搜尋引擎處理一個網頁大致分成三步:先「檢索」(下載網頁內容),再「建立索引」(理解內容並存進資料庫),最後才在搜尋時「呈現」。robots.txt 只作用在第一步,它能叫檢索器不要下載某個網址,卻管不到 Google 從其他地方得知這個網址的存在。
robots.txt 對不同檔案類型的效果
Google 依檔案類型說明了 robots.txt 的實際效果,三種情況差異很大,動手寫規則前先對照一次:
| 檔案類型 | 用 robots.txt 封鎖後會怎樣 | 適合的用法 |
|---|---|---|
| 網頁(HTML、PDF 等文字格式) | 檢索器不會抓取內容;但若其他網頁連結到它,網址仍可能被收錄,搜尋結果只顯示網址、不顯示說明 | 管理檢索流量、避開不重要或重複的網頁;不能拿來隱藏網頁 |
| 媒體檔案(圖片、影片、音訊) | 可以讓這些檔案不出現在 Google 搜尋結果中,但無法阻止其他網站或使用者直接連到檔案 | 不想讓特定圖片或影片出現在圖片、影片搜尋 |
| 資源檔案(CSS、JavaScript、圖片等) | Google 讀不到這些資源時,可能無法正確理解依賴它們的網頁 | 只封鎖對頁面呈現沒有影響的資源;版面與內容需要的 CSS、JS 不要擋 |
Disallow 不等於「不出現在搜尋結果」
很多教學會說「把不想被搜尋到的頁面寫進 Disallow」,這是最常見的誤解。Google 的規格文件寫得很清楚:被禁止檢索的網頁,Google 不會讀取內容,但仍可能為該網址建立索引並在搜尋結果中顯示,只是不會有網頁摘要。在 Search Console 的網頁索引報表裡,這種情況會出現「已建立索引,但遭到 robots.txt 封鎖」的狀態。
更麻煩的是,如果你在網頁上設了 noindex,又同時用 robots.txt 擋住它,Google 根本讀不到那個 noindex,網址反而可能繼續留在搜尋結果裡。想讓頁面不被收錄,應該讓檢索器讀得到頁面,再用 noindex 告訴它不要收錄;三種收錄控制工具(noindex、canonical、301 轉址)怎麼選,本站整理在 noindex、canonical、301 怎麼選這篇。
你的網站需要 robots.txt 嗎?先判斷三種情況
先說結論:沒有 robots.txt 的網站,Google 會視為沒有任何檢索限制,整個網站都可以檢索。Search Console 說明中心也表示,沒有 robots.txt 檔案代表 Google 可以檢索網站上所有網址,這本身沒有問題。所以「要不要寫」取決於你有沒有真正需要限制的網址,而不是「SEO 一定要有」。
| 網站情境 | 需要自己寫規則嗎 | 建議做法 |
|---|---|---|
| 頁數不多的形象官網、部落格 | 通常不需要 | 讓所有網頁都可檢索,只在檔案中寫上 Sitemap 位置即可 |
| 使用架站平台或代管服務 | 多半不能也不必直接編輯 | Google 說明 Wix、Blogger 這類服務可能無法直接改 robots.txt,改用平台的搜尋設定(例如每頁的索引選項) |
| 電商或有篩選、排序、站內搜尋的網站 | 值得規劃 | 封鎖會產生大量組合的篩選網址與站內搜尋結果頁,保留商品頁與分類頁 |
| 伺服器資源有限、被檢索拖慢的網站 | 需要,但先找原因 | 先查是哪些網址被大量檢索,再用規則排除;緊急降載另有做法(見後文狀態碼一節) |
| 測試站、內部系統 | 不要只靠 robots.txt | 用帳號密碼保護;robots.txt 是公開檔案,列出的路徑反而等於公告位置 |
最後一列常被忽略。robots.txt 的國際標準 RFC 9309 在安全考量一節特別提醒,這個協定不能取代真正的內容安全措施,把路徑寫進 robots.txt 等於公開告訴所有人這些路徑存在。後台、客戶資料、報價單這類內容,一定要用登入權限保護,而不是寫一行 Disallow 了事。
robots.txt 語法:四個欄位與「群組」怎麼讀
robots.txt 的每一行都是「欄位:值」的格式,欄位名稱不分大小寫(User-agent 和 user-agent 相同),冒號後面的空格可有可無,但加上比較好讀。井字號(#)後面的文字是註解,檢索器會忽略。Google 支援的欄位只有四個:
| 欄位 | 作用 | 寫法重點 |
|---|---|---|
| User-agent | 指定下面的規則適用哪個檢索器,是每個群組的第一行 | 星號(*)代表所有檢索器,但不包含 AdsBot 系列,AdsBot 要另外點名 |
| Disallow | 不允許檢索的路徑 | 以斜線(/)開頭;指目錄時以 / 結尾;沒有寫路徑的 Disallow 會被忽略 |
| Allow | 允許檢索的路徑,常用來在被封鎖的目錄中開放某個子目錄或檔案 | 寫法同 Disallow;路徑值區分大小寫 |
| Sitemap | 告訴搜尋引擎 Sitemap 的位置 | 必須是含 https:// 的完整網址;可以寫多行;不屬於任何群組 |
Google 的〈如何編寫及提交 robots.txt 檔案〉用了一個簡單範例說明這些欄位,換成白話就是下面這份檔案的意思:
| 檔案內容(逐行) | 意思 |
|---|---|
| User-agent: Googlebot | 開始一個只給 Googlebot 看的群組 |
| Disallow: /nogooglebot/ | Googlebot 不能檢索以 /nogooglebot/ 開頭的網址 |
| User-agent: * | 開始一個給其他所有檢索器的群組 |
| Allow: / | 其他檢索器可以檢索整個網站(不寫也一樣,預設就是允許) |
| Sitemap: https://www.example.com/sitemap.xml | Sitemap 的完整網址 |
群組:一個檢索器只會套用一組規則
從一行 User-agent 開始,到下一行 User-agent 之前的規則,就是一個「群組」。這裡有一個關鍵規則:對某個檢索器來說,只有一個群組會生效,就是 User-agent 寫得最明確、最符合它名稱的那一組,其他群組一律忽略,而且群組在檔案中的先後順序不影響判斷。
舉例來說,如果檔案裡同時有「User-agent: *」和「User-agent: Googlebot」兩組,Googlebot 只會看自己那一組,寫在星號群組裡的封鎖規則,對 Googlebot 完全不起作用。很多人在星號群組加了一行 Disallow,卻發現 Google 照樣檢索,原因就在這裡。若真要兩組都套用,必須把規則在 Googlebot 群組裡再寫一次。
另外兩個細節:同一個檢索器若被寫在好幾個群組,Google 會先把它們合併成一組;多個 User-agent 也可以連續寫在一起,共用下面的規則。至於 Sitemap 行,它不屬於任何群組,放在檔案開頭或結尾都可以。
Google 常見檢索器的 User-agent 名稱
一般網站很少需要針對個別檢索器寫規則,但如果只想讓圖片不出現在 Google 圖片搜尋,就需要知道名稱。下表整理 Google 常見檢索器清單中,robots.txt 會用到的幾個名稱:
| User-agent 名稱 | 影響範圍 | 常見用途 |
|---|---|---|
| Googlebot | Google 搜尋(含探索)與 Google 圖片、影片、新聞等產品 | 大多數規則只需要針對它或星號 |
| Googlebot-Image | Google 圖片,以及搜尋中顯示圖片、標誌、網站小圖示的功能 | 不想讓某些圖片出現在圖片搜尋 |
| Googlebot-Video | 影片相關的搜尋功能 | 不想讓某些影片檔被檢索 |
| Googlebot-News | Google 新聞 | 新聞網站才需要個別設定 |
AI 公司的檢索器(例如用於模型訓練的檢索器)也是用 robots.txt 的 User-agent 控制,但它們各自的名稱、影響範圍和「擋了會不會影響搜尋」都不一樣,本站另外整理在 GEO/AIO AI 搜尋主題頁的「AI 爬蟲與預覽控制」一節,這裡不重複。
Google 不支援的寫法:crawl-delay、noindex、nofollow
網路上流傳的範本常出現 Crawl-delay 或在 robots.txt 裡寫 Noindex,對 Google 都沒有作用。Google 的規格文件明列只支援上面四個欄位,不支援 crawl-delay 等其他欄位。Google 也在 2019 年宣布,自 2019 年 9 月 1 日起不再處理 robots.txt 中的 noindex 等未支援規則,要讓網頁不被收錄,請改用網頁上的 robots meta 標記或 X-Robots-Tag 回應標頭。
路徑比對與萬用字元:* 和 $ 怎麼用
Disallow 和 Allow 後面的路徑,是從網址的路徑開頭逐字比對。只要網址路徑「以這段文字開頭」就算符合,而且路徑值區分大小寫:Disallow: /file.asp 擋得住 /file.asp,卻擋不住 /FILE.asp。Google 與其他主流搜尋引擎支援兩個萬用字元:星號(*)代表零個或多個任意字元,錢字號($)代表網址結尾。
| 規則路徑 | 會符合 | 不會符合 |
|---|---|---|
| / | 根目錄與所有網址 | (無) |
| /$ | 只有首頁 | 首頁以外的所有網址 |
| /fish | /fish、/fish.html、/fish/salmon.html、/fishheads、/fish.php?id=anything | /Fish.asp、/catfish、/?id=fish、/desert/fish |
| /fish/ | /fish/、/fish/salmon.htm、/fish/?id=anything | /fish、/fish.html、/animals/fish/ |
| /*.php | /index.php、/folder/filename.php?parameters、/filename.php/ | /windows.PHP(大小寫不同) |
| /*.php$ | /filename.php、/folder/filename.php | /filename.php?parameters、/filename.php5 |
| /fish*.php | /fish.php、/fishheads/catfish.php?parameters | /Fish.PHP |
從表格可以看出幾個容易踩雷的地方。第一,結尾的星號會被忽略,/fish* 和 /fish 完全相同,不必畫蛇添足。第二,/fish 和 /fish/ 差一個斜線,範圍差很多:前者連 /fishheads 都會擋到,後者只擋 /fish/ 資料夾裡面的東西。第三,比對是從路徑開頭算起,/fish 不會擋到 /desert/fish;想擋「任何位置出現某段文字」的網址,要在前面加星號。
規則衝突時,誰說了算?
同一個群組裡,Allow 和 Disallow 可能同時符合某個網址。Google 的判斷原則有兩條:先看哪條規則的路徑比較長(比較明確),就用那一條;如果一樣長,就採用限制最少的規則,也就是 Allow。國際標準 RFC 9309 的寫法相同:最明確的比對以字元數最多為準,Allow 與 Disallow 相等時應採用 Allow。
| 網址 | 規則 | 結果與原因 |
|---|---|---|
| /page | Allow: /p 與 Disallow: / | 可檢索:/p 比 / 長,比較明確 |
| /folder/page | Allow: /folder 與 Disallow: /folder | 可檢索:一樣長時採用限制最少的 Allow |
| /page.htm | Allow: /page 與 Disallow: /*.htm | 不可檢索:/*.htm 較長,符合的字元較多 |
| / | Allow: /$ 與 Disallow: / | 可檢索:/$ 比較明確 |
| /page.htm | Allow: /$ 與 Disallow: / | 不可檢索:/$ 只符合首頁,所以由 Disallow: / 生效 |
最後兩列的組合很實用:「Allow: /$」搭配「Disallow: /」,代表只開放首頁、其他全部封鎖。不過這種寫法在一般企業網站很少需要,寫之前先確認你真的想讓其他網頁都不被檢索。
中文網址與編碼
如果網址路徑含有中文,Google 會把規則與網址都轉成百分比編碼再比對,所以直接寫中文或寫編碼後的字串,效果相同。真正要注意的是檔案本身:robots.txt 必須以 UTF-8 編碼儲存,Google 會忽略不屬於 UTF-8 範圍的字元,可能讓含中文的規則失效。
常見情境怎麼寫?七個可直接套用的範例
下面的範例以「User-agent: *」為例,代表規則給所有檢索器。實際使用時,把路徑換成你網站真正的路徑;每個範例都是一個完整群組,如果檔案裡已經有其他群組,記得前一節提到的規則:針對 Googlebot 另有群組時,要在那一組也寫一次。
| 情境 | 寫法(每行以「/」分隔) | 說明 |
|---|---|---|
| 允許所有檢索器檢索整個網站 | User-agent: * / Disallow: | Disallow 後面留空等於沒有限制;也可以直接不放 robots.txt |
| 封鎖整個網站 | User-agent: * / Disallow: / | 只適合暫時性的特殊情況;正式網站誤留這行會讓檢索全面停止 |
| 封鎖某個目錄 | User-agent: * / Disallow: /admin/ | 目錄以斜線結尾;後台仍要用登入保護 |
| 封鎖目錄但開放其中一個檔案 | User-agent: * / Disallow: /docs/ / Allow: /docs/catalog.pdf | Allow 的路徑較長,所以 catalog.pdf 可檢索 |
| 封鎖站內搜尋結果頁 | User-agent: * / Disallow: /search | 站內搜尋會產生大量內容重複、沒有獨立價值的網址 |
| 封鎖帶篩選參數的網址 | User-agent: * / Disallow: /*?*color= / Disallow: /*?*size= | 依 Google 多面向導覽說明,篩選組合通常不值得檢索;商品頁與未篩選的分類頁要保持開放 |
| 不讓某資料夾的圖片出現在圖片搜尋 | User-agent: Googlebot-Image / Disallow: /images/private/ | 只影響圖片相關功能,網頁本身仍可被檢索 |
以上範例最後都可以再加一行 Sitemap,寫上完整網址,例如「Sitemap: https://www.example.com/sitemap.xml」。Google 的說明把兩者的分工講得很清楚:Allow 和 Disallow 告訴 Google「可以」或「不可以」檢索什麼,Sitemap 則告訴 Google「應該」檢索哪些網址。網站有多個 Sitemap 時,可以寫多行。
寫一份新的 robots.txt:四個步驟
- 用純文字編輯器(記事本、TextEdit 等)建立檔案,不要用 Word 這類文書軟體,它們可能加入彎引號等不相容的字元;存檔時選 UTF-8 編碼
- 檔名必須是全小寫的 robots.txt,一個網站只能有一份
- 依前面的範例寫入規則,每個群組以 User-agent 開頭,最後加上 Sitemap 完整網址
- 上傳到網站主機的根目錄,讓它出現在「https://你的網域/robots.txt」,再依後文的方法測試
已經有 robots.txt 的網站,修改時先把線上版本下載或複製下來,在原檔上改,避免漏掉原本就有的規則。Google 也提醒,如果你沒有上傳檔案到網站根目錄的權限,例如網站放在別人網域的子目錄下,就要請網域管理者代為修改。
檔案位置與適用範圍:每個主機各自一份
robots.txt 只對「放置它的那個主機、通訊協定和通訊埠」有效,這一點在網站有多個子網域時特別重要。https://example.com/robots.txt 的規則,不會套用到 https://shop.example.com/,也不會套用到 http://example.com/。每個子網域都要有自己的檔案。
| robots.txt 網址 | 適用於 | 不適用於 |
|---|---|---|
| https://example.com/robots.txt | https://example.com/ 底下所有路徑 | https://other.example.com/、http://example.com/、https://example.com:8181/ |
| https://www.example.com/robots.txt | https://www.example.com/ | https://example.com/、https://shop.www.example.com/ |
| https://example.com/folder/robots.txt | 不是有效的 robots.txt | 檢索器不會到子目錄找這個檔案 |
實務上最常見的狀況是:主網站和網路商店、部落格分別在不同子網域,管理者只改了主網域的 robots.txt,就以為全站都套用了。也有人把檔案放進 /pages/ 之類的子目錄,結果完全沒有作用。放錯位置的 robots.txt,對檢索器來說等於不存在。
用 Search Console 的網域資源時,robots.txt 報表會列出網站上檢索次數最多的前 20 個主機各自的 robots.txt,是一次檢查所有子網域的好方法。Search Console 本身的設定與網域驗證方式,可以參考 Google Search Console 怎麼用。
最常見的 10 個錯誤與修正方式
下面這張表整理 robots.txt 最常見的錯誤,每一項都對照 Google 文件中的規則,可以拿來逐項檢查自己的檔案:
| 錯誤 | 實際後果 | 怎麼修正 |
|---|---|---|
| 網站上線後忘了刪除 Disallow: / | 整個網站停止被檢索,新內容進不了索引 | 上線檢查清單加一項:打開 /robots.txt 確認沒有全站封鎖 |
| 用 Disallow 隱藏不想被搜到的網頁 | 網址仍可能因外部連結被收錄,只是沒有摘要 | 讓網頁可被檢索,改用 noindex;機密內容用密碼保護 |
| 同一頁設了 noindex 又被 robots.txt 封鎖 | Google 讀不到 noindex,網址可能繼續出現 | 先移除 robots.txt 的封鎖,等網頁從索引消失 |
| 封鎖了版面需要的 CSS、JavaScript | Google 可能無法正確理解網頁內容 | 只封鎖對呈現沒有影響的資源 |
| 把規則寫在星號群組,以為對 Googlebot 也有效 | 若另有 Googlebot 群組,星號群組的規則對它無效 | 在 Googlebot 群組重複寫入需要的規則 |
| 路徑大小寫不符 | /Admin/ 擋不到 /admin/ | 照實際網址的大小寫撰寫,必要時兩種都寫 |
| 放在子目錄或只放主網域 | 其他主機或錯誤位置的規則完全不生效 | 每個子網域根目錄各放一份 |
| 用文書軟體編輯或非 UTF-8 編碼 | 彎引號、亂碼讓規則無法解析 | 用純文字編輯器,以 UTF-8 存檔 |
| 寫 Crawl-delay、Noindex 期待 Google 照做 | Google 忽略這些欄位 | 改用 Google 支援的方法(noindex 標記、降載狀態碼) |
| 用 robots.txt 列出後台、測試站路徑 | 路徑公開,任何人都看得到 | 用登入權限保護,不必寫進 robots.txt |
這十項裡,第一項的殺傷力最大。新網站建置期間為了不讓半成品被收錄,常會先設全站封鎖,正式上線時卻忘了拿掉,結果網站上線好幾週都沒有任何曝光。網站搬家時也一樣,舊站的封鎖規則或 noindex 沒有及時移除,是 Google 列出的常見遷移錯誤之一;搬家的完整步驟可以參考 網站搬家怎麼做。
第二、三項則是「越想藏、越藏不住」的典型。要記得,robots.txt 是公開的、只管檢索的檔案;決定一個網頁「出不出現在搜尋結果」,要靠網頁本身的 noindex 或 HTTP 標頭,決定「誰能看到」則要靠登入權限。
怎麼測試 robots.txt?確認規則真的生效的方法
規則寫好、上傳之後,不要假設它一定正確。Google 建議的測試流程可以拆成四個層次,從「檔案在不在」一路檢查到「某個網址到底有沒有被擋」:
- 確認檔案可公開存取:用瀏覽器的無痕視窗開啟「https://你的網域/robots.txt」,能看到檔案內容才算成功;看到登入頁、錯誤頁或空白,代表檢索器也拿不到
- 查看 Search Console 的 robots.txt 報表:開啟報表後確認擷取狀態為「已擷取」、上次檢查時間,以及「問題數」欄位有沒有剖析錯誤或警告
- 用網址檢查工具測試個別網址:輸入你擔心被誤擋的重要網頁,查看檢索是否被允許;修改規則後可按「測試線上網址」看最新結果
- 對照網頁索引報表:查看「網址遭到 robots.txt 封鎖」與「已建立索引,但遭到 robots.txt 封鎖」兩種狀態的網址,確認被擋的都是你刻意排除的網頁
Search Console 說明中心的〈robots.txt 報表〉說明,這份報表會顯示 Google 為網站前 20 個主機找到的 robots.txt、上次檢索時間與遇到的警告或錯誤,出現「錯誤」時規則無法使用,「警告」則不影響;點進檔案還能看到過去 30 天內擷取到的不同版本,方便對照是哪一次修改出了問題。
修改後多久生效?什麼時候要「要求重新檢索」
Google 通常會快取 robots.txt 的內容,最多保留 24 小時,所以修改後不一定馬上生效。如果你剛解除了重要網址的封鎖,或修正了嚴重錯誤,可以在 robots.txt 報表中選取檔案旁的更多選項,點「要求重新檢索」。不過說明中心也提醒,Google 本來就會經常重新檢索 robots.txt,一般修改不需要特別提出要求,而且解除封鎖不保證那些網址會立刻被重新檢索。
舊版「robots.txt 測試工具」去哪了?
早期 Search Console 有一個可以貼上網址、即時測試是否被封鎖的「robots.txt 測試工具」,2023 年底已由現在的 robots.txt 報表取代。現在要測試單一網址,請用網址檢查工具;開發人員則可以使用 Google 公開的開放原始碼 robots.txt 剖析程式庫(也就是 Google 搜尋實際使用的程式庫),在自己電腦上測試規則。
robots.txt 本身出錯會怎樣?狀態碼、快取與檔案大小
很少人注意到:robots.txt 這個檔案「回應什麼狀態碼」,會直接改變 Google 的檢索行為。依 Google 對 robots.txt 規格的說明,整理如下:
| robots.txt 回應 | Google 的處理方式 | 要注意什麼 |
|---|---|---|
| 2xx 成功 | 讀取並套用檔案中的規則 | 確認內容是純文字規則,不是 HTML 頁面 |
| 3xx 重新導向 | 至少追蹤 5 次重新導向;超過就視為 404 | 避免重新導向鏈過長,讓檢索器能順利取得檔案 |
| 4xx(429 除外) | 視為沒有 robots.txt,也就是沒有任何檢索限制 | 不要用 401、403 來限制檢索頻率,它們沒有這個效果 |
| 5xx 伺服器錯誤 | 前 12 小時停止檢索整個網站;之後 30 天內沿用最後一個可用版本 | 這是最危險的狀況,robots.txt 出錯可能讓整站停擺 |
| DNS 或網路錯誤、逾時 | 比照伺服器錯誤處理 | 主機不穩時,robots.txt 也要列入監控 |
5xx 這一列值得多看兩眼。根據 Google 的說明,如果 robots.txt 存在卻回應伺服器錯誤,Google 會在最初 12 小時內停止檢索網站,接下來 30 天沿用上一個可用版本;30 天後仍未修正,若網站其他部分大致正常,Google 會當作沒有 robots.txt。換句話說,一個看似無關緊要的小檔案出錯,可能讓整個網站的檢索暫停。國際標準 RFC 9309 也規定,robots.txt 因伺服器錯誤無法取得時,檢索器必須假設全部禁止。
檔案格式與大小限制
- 大小上限 500 KiB:Google 會忽略超過的部分。規則太多時,把要排除的內容集中到少數目錄,用一行目錄規則取代大量單一網址
- 換行與編碼:每行以 CR、CR/LF 或 LF 分隔,以 UTF-8 儲存;檔案開頭的 BOM 等無效內容會被忽略
- 無效行會被略過:Google 只使用能夠剖析的行,寫錯的那一行不會讓整份檔案失效,但那條規則等於沒寫
- 快取:一般最多 24 小時;無法更新時(例如逾時或 5xx)會延長使用舊版本
網站被檢索拖慢時,不要急著改 robots.txt
有時網站主發現 Googlebot 請求太多、主機變慢,第一反應是在 robots.txt 加封鎖。Google 的〈降低 Google 檢索頻率〉說明建議先找原因:檢索量暴增最常見的原因,是篩選、排序功能或日曆產生了大量網址。真的需要在幾小時到一兩天內緊急降載,可以讓伺服器暫時回應 500、503 或 429 狀態碼;但最多不應超過一到兩天,否則持續出現這些狀態碼的網址可能被移出索引。
用架站平台怎麼辦?以 Sharing AI 為例的檢查方式
使用架站平台或代管服務的網站,往往不能直接上傳 robots.txt。Google 在建立 robots.txt 的說明開頭就提到,Wix、Blogger 這類服務可能不需要、也無法直接編輯 robots.txt,而是透過平台的搜尋設定告訴搜尋引擎哪些網頁要不要檢索或收錄。這時候你的工作從「寫規則」變成「確認平台產生的規則是否合理」。
以本站知識庫介紹的 Sharing AI 架站平台為例,官方列出的功能包含自動產生 robots.txt 與 Sitemap。以本站自己的網站來說,開啟「網域/robots.txt」可以看到只有一個給所有檢索器的群組,封鎖少數幾個非公開頁面的路徑(例如 /preview/),最後一行寫著 Sitemap 的完整網址。這樣的設定讓正式網頁都能被檢索,同時避開不需要被檢索的路徑。
- 在瀏覽器開啟「你的網域/robots.txt」,確認檔案存在、沒有「Disallow: /」這種全站封鎖
- 確認 Sitemap 那一行的網址能正常開啟,並在 Search Console 提交同一個網址
- 不想被收錄的單一頁面(例如表單感謝頁、內部活動頁),在後台頁面設定的「SEO 基本設定」選擇不索引(noindex),而不是設法改 robots.txt
- 在 Search Console 的 robots.txt 報表確認擷取狀態正常,網頁索引報表中沒有重要網頁被封鎖
第三步是平台使用者最需要記住的:在平台上控制「某一頁不要出現在搜尋結果」,用的是頁面的索引設定,而不是 robots.txt。這也正好符合 Google 的建議,noindex 才是讓網頁不被收錄的正確工具。表單感謝頁的實際設定方式,可以參考 網站表單怎麼設計中的說明。
上線前後的 robots.txt 檢查清單
把下面這份清單放進網站上線、改版、搬家時的例行檢查,大部分問題都能在發生前攔下來:
- 正式網站的 robots.txt 沒有「Disallow: /」,建置期的全站封鎖已移除
- 每個子網域(www、商店、部落格)各自的 robots.txt 都檢查過
- 想讓搜尋者找到的網頁都沒有被 Disallow,版面需要的 CSS、JavaScript 沒有被擋
- 不想被收錄的網頁使用 noindex,且沒有同時被 robots.txt 封鎖
- 後台、客戶資料、測試站用登入權限保護,而不是只靠 robots.txt
- 檔案為 UTF-8 純文字、小於 500 KiB,路徑大小寫與實際網址一致
- 沒有 Crawl-delay、Noindex 這類 Google 不支援的欄位期待生效
- Sitemap 行寫的是含 https:// 的完整網址,且與 Search Console 提交的一致
- 修改後在 robots.txt 報表確認「已擷取」、沒有錯誤,並用網址檢查工具測試幾個重要網頁
- 保留每次修改前的版本與日期,方便日後對照索引數量變化
robots.txt 只是讓 Google 順利找到網站的其中一環。網站剛上線、想從頭確認收錄狀況,可以從 網站 SEO 健檢第一步開始;網站內部的連結結構會影響檢索器能不能找到每一頁,做法整理在 內部連結怎麼做。如果希望有人協助檢查網站的檢索與索引設定、排出改善順序,也可以了解分享家的 AI SEO 顧問服務;更多搜尋相關主題,都收錄在 SEO 搜尋引擎最佳化主題頁。